Снижение технического долга: практическое руководство для CTO
Классические рецепты («правило бойскаута», «пятничные фиксы» и размытые 20% времени спринта на рефакторинг) в современных условиях перестали работать. Они фокусируются на косметической чистке отдельных строк кода, в то время как главные потери бизнес несет на уровнях архитектуры и структуры команд.
Ниже — практический фреймворк для технических лидеров: как сделать техдолг измеримым, защитить инвестиции перед генеральным и финансовым директорами и перестроить инженерные процессы без заморозки продуктовой разработки
1. Корень проблемы: почему инициативы захлебываются
По данным McKinsey, технический долг связывает от 10% до 20% IT-бюджета и «съедает» до 40% стоимости технологических активов компании еще до их амортизации. Тем не менее попытки его сократить регулярно проваливаются по трем причинам
- Проблема прозрачности, а не бэклога. Руководство компании не станет финансировать абстрактный «рефакторинг». Пока долг описан языком недовольства разработчиков, а не метриками бизнес-рисков (деньги, задержка релизов, уязвимости), он всегда будет проигрывать задачам продуктового роадмапа
- Ловушка локальной оптимизации. Красивое оформление кода или разбиение на мелкие фичи дают иллюзию прогресса, но не решает системных проблем со связностью модулей
- Отсутствие защищенного ресурса. Как только сдвигаются дедлайны по ключевым фичам (P0), незащищенные часы на инженерные улучшения первыми идут под нож
Три уровня техдолга: разделяйте и управляйте
С 1992 года, когда Уорд Каннингем ввел термин «технический долг», индустрия привыкла связывать его исключительно с кодом. На практике зрелая система управления должна охватывать три самостоятельных слоя:
- Организационный долг (люди, владение, знания)
- Архитектурный долг (сервисы, контракты, зависимости)
- Долг на уровне кода (файлы, тесты, библиотеки)
Уровень 1: Долг в кодовой базе
- Симптомы: дублирование, спагетти-логика, нехватка тестов, заброшенные библиотеки с уязвимостями
- Радиус поражения: локальный (за исключением общих shared-библиотек)
- Инструменты: линтеры, статический анализ (SonarQube, Semgrep), SCA/SAST-сканеры, плановое код-ревью и инструменты генерации кода на базе LLM
Уровень 2: Архитектурный долг (главный мультипликатор сложности)
- Симптомы: циклические зависимости между сервисами, не зафиксированные в контрактах интеграции («работает на негласных договоренностях»), сервисы-зомби без назначенных команд-владельцев
- Радиус поражения: системный. Правка одного API вынуждает шесть смежных команд синхронно выкатывать релизы в нерабочее время
- Инструменты: анализ графа зависимостей, Service Catalogs, архитектурные фитнес-функции (fitness functions) в CI/CD, отслеживание трейсов (distributed tracing)
Уровень 3: Организационный долг
- Симптомы: «фактор автобуса» равен 1 (вся критическая логика держится на двух ключевых архитекторах); продуктовые команды нарезаны вопреки границам микросервисов; KPI завязаны исключительно на скорость выпуска новых фич без учета их стабильности
- Радиус поражения: стратегический. При увольнении ключевых сотрудников проект оказывается парализован
- Инструменты: выравнивание команд по принципам Team Topologies, ревизия матрицы владения сервисами, пересмотр системы инженерной мотивации
3. Матрица приоритизации: как отбирать задачи
Классический квадрат Мартина Фаулера объясняет происхождение долга (преднамеренный/непреднамеренный, разумный/безрассудный), но не отвечает на вопрос, за что браться прямо в понедельник.
Для приоритизации внедрите формулу из трех параметров
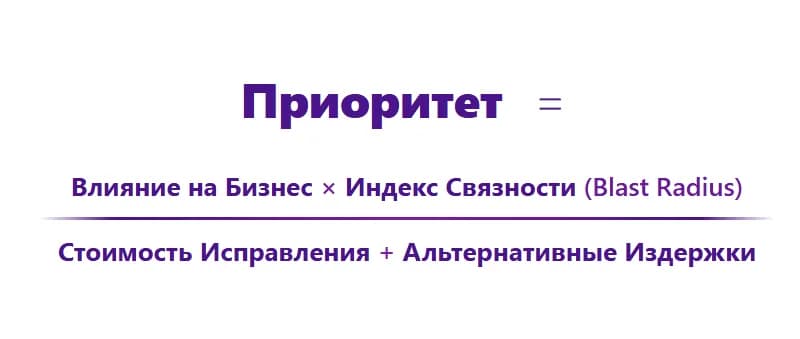
- Влияние на бизнес. Переведите проблему на язык денег и потерь
- Сколько часов простоя в месяц вызывает этот узел?
- На сколько миллисекунд он замедляет отклик и как это режет конверсию?
- Блокирует ли он соответствие требованиям комплаенса и безопасности?
- Индекс связности (Blast Radius). Зависимость, на которую завязано пять ключевых бизнес-процессов, всегда имеет приоритет над долгом в изолированном модуле
- Реальная стоимость изменений. Учитывайте не только человеко-часы инженера, но и риски регрессии, необходимость межкомандной синхронизации и время на сквозное тестирование
4. Как вести рабочий реестр техдолга
Откажитесь от разрозненных страниц в Confluence. Реестр долга жизнеспособен только при соблюдении трех правил:
- Единое рабочее пространство. Задачи по долгу живут в том же трекере (Jira, Linear), что и продуктовые фичи. Они имеют строгий лейбл
tech-debt, тип (code,architecture,organization) и оценку влияния - Обязательные поля. Ни одна задача не попадает в бэклог без заполненных граф: «Что ломается/замедляется сейчас» и «Ожидаемый выигрыш для метрик надежности или скорости поставки»
- Регулярный груминг с участием лидеров. Раз в месяц технический директор или ведущие архитекторы проводят ревизию этого списка, отбирая кандидатов для ближайших спринтов. Задачи, потерявшие актуальность за полгода, безжалостно архивируются
5. Стратегии сокращения долга без остановки роадмапа
Бизнес никогда не одобрит остановку разработки ради мифической «чистки кода на полгода». Устойчивые стратегии встраиваются в текущую поставку:
| Стратегия | Для какого уровня подходит | Как применять | Чего избегать |
|---|---|---|---|
| Защищенная квота (Capacity Floor) | Код, архитектура | Жестко резервируйте 15–20% емкости каждого спринта. Это инженерный аналог техобслуживания станков, а не бонусное время | Не позволяйте размывать эту квоту задачами «заодно доделать фичу» |
| Архитектурные фитнес-функции | Архитектура | Настройте тесты в пайплайне CI/CD, автоматически проверяющие запрет на циклические вызовы модулей и соблюдение API-контрактов | Ручных проверок на словах в процессе ревью |
| Паттерн «Душитель» (Strangler Fig) | Архитектура, системы | Постепенно перехватывайте вызовы к устаревшему монолиту новыми сервисами через прокси/шлюз до полного вывода монолита из эксплуатации | Попыток переписать всё «с чистого листа» за один релиз (Big-Bang Rewrite) |
| AI-ассистенты и цифровой двойник | Код, архитектура | Используйте специализированные модели для покрытия легаси-кода тестами перед рефакторингом и построения актуального графа зависимостей | Доверия сгенерированному ИИ коду без строгого архитектурного ревью и автоматических тестов |
6. Антипаттерны, разрушающие инженерную инициативу
- Переписывание с нуля (Big-Bang Rewrite). Старая система продолжает работать и приносить доход, пока новая два года пишется параллельно, стремительно устаревая еще до первого релиза. Модернизируйте системы исключительно инкрементально
- Бесконечный перенос на «следующий спринт». Если у технических инициатив нет фиксированного слота в емкости команды, операционная текучка вытеснит их со 100% вероятностью
- Техдолг как внутренняя тайна инженеров. Если CTO не защищает бюджет на рефакторинг аргументами о надежности, скорости вывода продуктов (Time-to-Market) и снижении затрат на инфраструктуру, бизнес будет справедливо воспринимать эти работы как потерю ресурсов
- Снижение без метрик. Измеряйте объективную динамику инженерной эффективности через метрики DORA (частота деплоев, Lead Time изменений, частота сбоев Change Failure Rate и среднее время восстановления MTTR). Если долг «устраняется», а MTTR растет — команда гасит не те проблемы
Чек-лист для CTO: план действий на квартал
- Провести аудит владения сервисами: выявить компоненты без ответственных команд («ничьи» сервисы) и назначить владельцев
- Построить граф критических зависимостей: локализовать циклические связи и внешние узлы с наивысшим радиусом поражения
- Зафиксировать квоту в спринтах (15–20%): согласовать с продуктовым руководством несгораемый лимит мощностей на устранение критических блокеров
- Внедрить жесткие Quality Gates в CI/CD: автоматизировать проверку уязвимостей, покрытия критических путей тестами и контроль архитектурных контрактов
- Связать техдолг с бизнес-метриками: вынести на ежеквартальные встречи с топ-менеджментом динамику инцидентов и скорость релизных циклов вместо списков мелких багов


